CAPÍTULO 3 · Cada pieza encuentra su responsabilidad
Una página pequeña también puede trabajar de más
La tabla devuelve solo los registros de una página y, aun así, necesitamos entender cuánto trabajo realiza el servidor. Imaginemos que cada sensor muestra también el nombre de su estación. Si al representar cada fila el ORM hace una consulta adicional, el costo crece con el número de elementos aunque la vista parezca breve y ordenada.
Reconocemos el problema N+1 y revisamos las relaciones que realmente utiliza el serializer. select_related o prefetch_related permiten preparar los datos según su estructura. La optimización pertenece al queryset del consumidor, mientras el paginador común conserva su función. Medimos las consultas para comprobar el resultado en lugar de juzgarlo por la cantidad de líneas.
Con menos viajes innecesarios, cada petición trabaja mejor. Pero las peticiones no llegan de una en una: usuarios, dispositivos y tareas pueden coincidir. Ahora necesitamos mirar otro recurso compartido. Además de cuántas consultas hacemos, importa cuántas conexiones abrimos para ejecutarlas y cuánto tiempo permanecen ocupadas.
Leer esta parte dentro del relato completo →DEL RELATO A LA PRÁCTICA
Vamos a desarrollar esta decisión con su mapa, explicación, código y ejercicio.
MIRA · CONECTA · COMPRENDE
Traer las piezas en pocos viajes
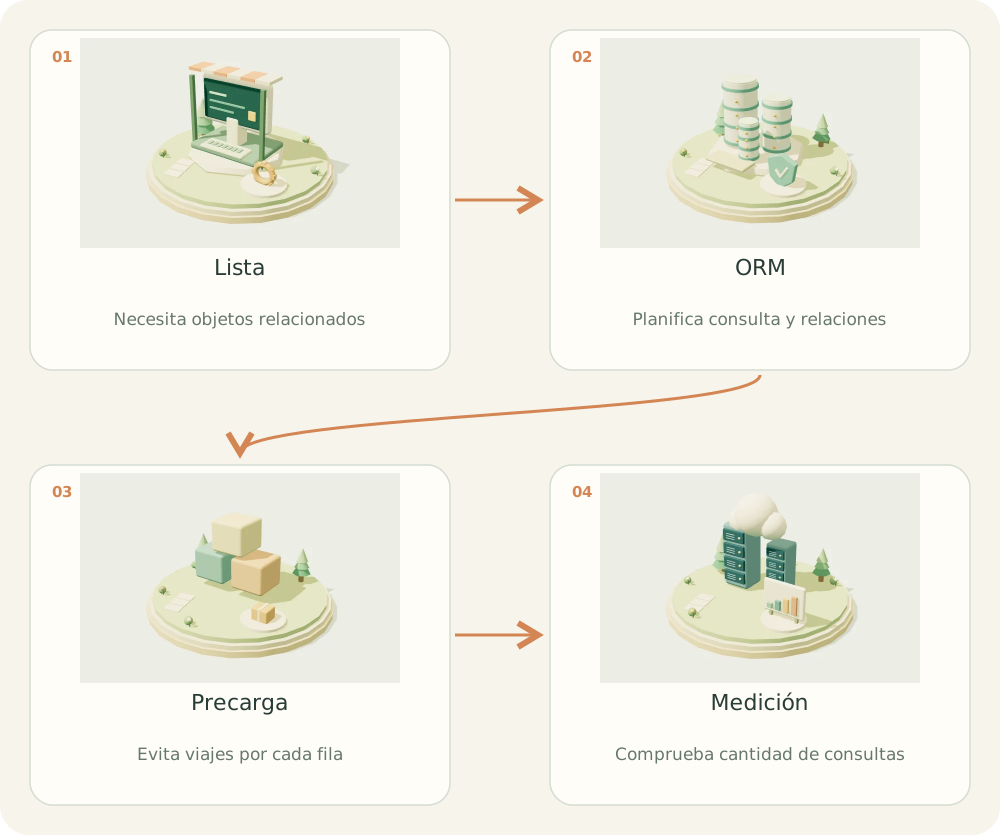
Las flechas resumen el recorrido conceptual. Los controles y dependencias se detallan debajo.
Selecciona una pieza para destacar su responsabilidad.
Leer la explicación del mapa
- Lista. Necesita objetos relacionados
- ORM. Planifica consulta y relaciones
- Precarga. Evita viajes por cada fila
- Medición. Comprueba cantidad de consultas
01 / EL PROBLEMA
¿Para qué sirve?
Un serializer que accede a station puede ejecutar una consulta por sensor. La aplicación parece rápida con dos filas y lenta con cientos.
02 / COMPRENDER
El concepto, explicado
select_related hace joins para ForeignKey y OneToOne. prefetch_related obtiene colecciones con consultas separadas y las asocia en memoria.
Los índices ayudan filtros y orden frecuentes; no se agregan sin pensar en costo de escritura. Inspecciona SQL y planes antes de optimizar a ciegas.
Reutilizar conexiones y evitar N+1 resuelven problemas diferentes. El pool reduce aperturas y limita conexiones simultáneas; select_related y prefetch_related reducen viajes de consulta. Un listado con 101 consultas sigue teniendo 101 consultas aunque use un pool. La siguiente lección conecta ambas decisiones.
03 / CONSTRUIR
Implementación paso a paso
- Identifica relaciones usadas al serializar.
- Precarga solo lo necesario.
- Mide número de consultas para varias filas.
- Añade índices basados en patrones de consulta.
04 / APLICAR
Ejemplo en SensorHub
from django.test import TestCase
from catalogo.models import Sensor
from catalogo.serializers import SensorSerializer

class SensorQueryTests(TestCase):
    def test_serialization_uses_one_query(self):
        # Crea las estaciones y sensores de prueba antes de este bloque.
        with self.assertNumQueries(1):
            rows = Sensor.objects.select_related("station")
            list(SensorSerializer(rows, many=True).data)
Cómo leer el ejemplo
- El queryset es lazy: la consulta ocurre al consumir serializer.data.
- La prueba necesita fixtures con sensores reales para ser representativa.
- En relaciones muchos-a-muchos, prefetch normalmente utiliza más de una consulta total pero evita N+1.
Error habitual
Comparar tiempos sin datos reales ni conteo de consultas puede esconder el problema.
05 / PRACTICAR
Tu turno
Haz que una lista de 20 sensores no ejecute 20 consultas de estaciones.
Ver solución orientativa
Usa select_related("station") en get_queryset y prueba que el número de consultas no crece con el tamaño de página.
06 / VERIFICAR
Cómo sabes que funciona
- El número de consultas permanece acotado.
- La salida contiene el mismo contrato antes y después de optimizar.
CONTINUAR LA EXPERIENCIA
El siguiente paso del recorrido:
psycopg 3: reutilizar conexiones con un pool →Continuar en modo relato