CAPÍTULO 10 · Operar también es desarrollar
Observar el servicio sin recolectar todo indefinidamente
Las comprobaciones de salud ofrecen señales útiles, pero no explican por sí solas una latencia creciente o un error que solo ocurre bajo ciertas condiciones. Para investigar necesitamos información de operación. Al mismo tiempo, recolectar y conservar datos sin criterio puede generar ruido, exponer detalles innecesarios y aumentar el consumo.
Definimos qué telemetría aporta valor y cómo se administrará su volumen. Application Insights entra en esa decisión como herramienta de observación, con condiciones de uso y costos que debemos comprender. La pregunta no es cuántos registros podemos reunir, sino cuáles nos ayudan a tomar una acción y durante cuánto tiempo los necesitamos.
La aplicación web se vuelve más observable. Pero SensorHub forma parte de un recorrido mayor: las mediciones dependen de componentes previos a Django. Para interpretar un problema de extremo a extremo necesitamos ampliar la mirada hacia la infraestructura que recibe y transporta la información de los dispositivos.
Leer esta parte dentro del relato completo →DEL RELATO A LA PRÁCTICA
Vamos a desarrollar esta decisión con su mapa, explicación, código y ejercicio.
MIRA · CONECTA · COMPRENDE
Observar sin enviar ruido ilimitado
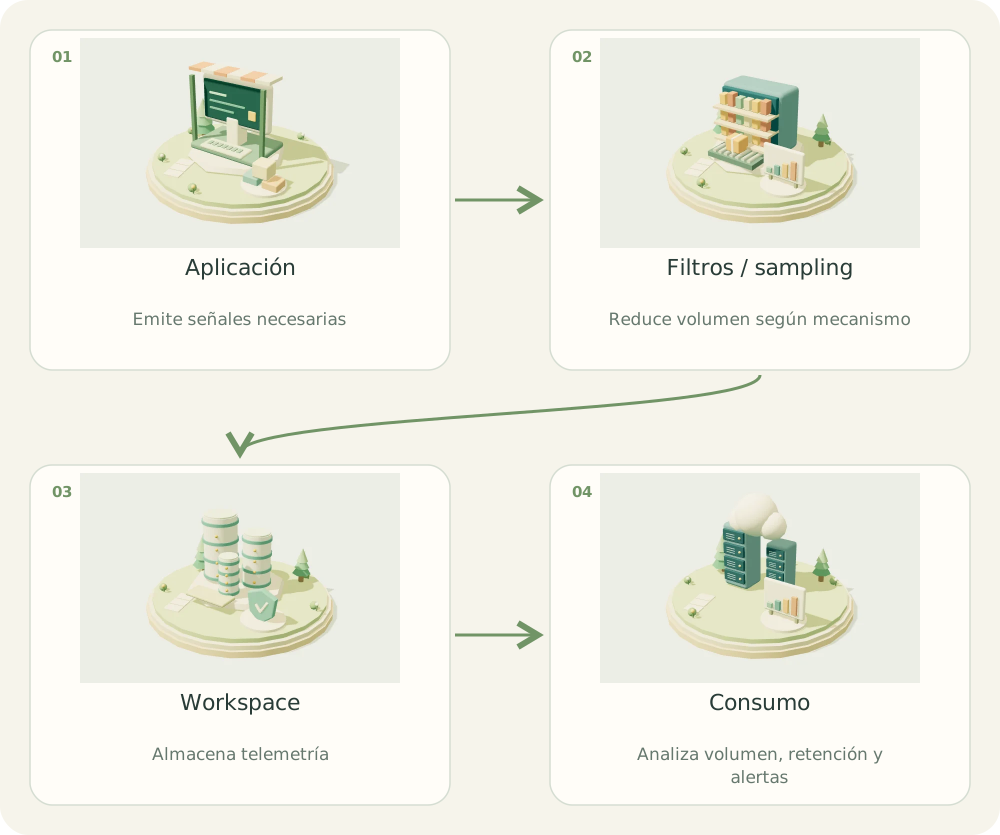
Las flechas resumen el recorrido conceptual. Los controles y dependencias se detallan debajo.
Selecciona una pieza para destacar su responsabilidad.
Leer la explicación del mapa
- Aplicación. Emite señales necesarias
- Filtros / sampling. Reduce volumen según mecanismo
- Workspace. Almacena telemetría
- Consumo. Analiza volumen, retención y alertas
01 / EL PROBLEMA
¿Para qué sirve?
La telemetría permite investigar errores, pero enviar cada evento sin criterio puede generar consumo inesperado y exponer datos sensibles.
02 / COMPRENDER
El concepto, explicado
Application Insights basado en workspace usa Log Analytics para logs. No todo dato o métrica de Azure tiene el mismo almacenamiento y medidor: revisa los cargos concretos y su plan.
Atribuye volumen por recurso y tabla. _BilledSize sirve para analizar bytes de registros facturables; no multipliques indiscriminadamente todo dato por una tarifa única.
Sampling reduce parte de la telemetría antes de ingestión; ItemCount indica eventos representados cuando se aplica ese mecanismo. No todos los logs o señales siguen el mismo muestreo.
El daily cap es una salvaguarda, no un límite monetario exacto: puede haber exceso y detener recolección. En Application Insights basado en workspace revisa límites de aplicación y workspace, además de alertas y retención.
03 / CONSTRUIR
Implementación paso a paso
- Define señales necesarias: errores, latencia, dependencias y correlación.
- Desactiva captura de secretos, cuerpos sensibles y logs redundantes.
- Revisa facturación del workspace por tabla y recurso en el período elegido.
- Configura sampling/filtros soportados y comprueba volumen antes/después.
- Ajusta retención y alertas tempranas; usa cap solo con plan para pérdida de visibilidad.
- Revisa consumo de todos los recursos compartidos y registra decisiones.
04 / APLICAR
Ejemplo en SensorHub
// KQL para logs de Application Insights en un workspace.
union withsource=Tabla AppRequests, AppDependencies, AppTraces, AppExceptions
| where TimeGenerated >= ago(7d)
| where _IsBillable == "true"
| summarize Bytes=sum(_BilledSize), Registros=count()
    by Tabla, _ResourceId
| extend GiB=round(Bytes / 1073741824.0, 3)
| order by GiB desc
Cómo leer el ejemplo
- Ejecuta en el workspace correcto; tablas ausentes requieren adaptar la consulta.
- GiB es volumen para análisis, no una factura ni necesariamente la unidad comercial del medidor.
- No agrupes solo por nombre corto si recursos distintos pueden coincidir.
Error habitual
Tomar una estimación cero del App Service como costo total o usar daily cap para detener exactamente una cantidad de dólares.
05 / PRACTICAR
Tu turno
AppTraces crece por un log por medición IoT. Reduce consumo conservando evidencia útil.
Ver solución orientativa
Usa métricas agregadas y trazas muestreadas para actividad normal; registra errores y eventos necesarios. Mide volumen e impacto de diagnóstico, ajusta retención y mantén alertas.
06 / VERIFICAR
Cómo sabes que funciona
- El consumo se atribuye a recurso y tabla.
- El muestreo se verifica con señales pertinentes.
- Un cap alcanzado genera aviso y respuesta operativa.
Para profundizar
Documentación oficial para comprobar configuración, permisos y condiciones vigentes. Revisión del tema: 2026-10-11.
CONTINUAR LA EXPERIENCIA
El siguiente paso del recorrido:
Infraestructura de un servidor LoRa en Azure →Continuar en modo relato